静的サイトの検索窓で「か」「ka」でもヒットするようにする|ビルド時にwanakanaでかな展開する方式
概要
今回は静的サイトの検索窓で、ひらがな・ローマ字の部分入力でもヒットするようにした対応について紹介していきます。
自作の旅しおりポータルにサイドバー検索窓を付けていたのですが、「軽井沢」というしおりを探すのに漢字の「軽井沢」と打てばヒットするのに、読みの「か」やローマ字の「ka」で打つとヒットしないことに気付きました。
調べてみると、部分一致検索のロジック自体はすでに実装済みだったんですよね。
原因は別のところにあったので、そこも含めて整理していきます。
それではやっていきましょう!
目次
起きていた問題
サイドバー検索窓(#search-input)の実体はjs/search.jsのfilterItineraries()という関数です。
中身を見てみると、String.includes()による部分一致検索自体はすでに実装されていたのがわかりました。
js/search.js(既存の抜粋)
1 | const haystack = [title, destination, summary, tags].join(" ").toLowerCase(); |
ただこのhaystack(検索対象文字列)に入っているのは、title/destination/summary/tagsという漢字表記のフィールドだけでした。
「軽井沢」という漢字の文字列に対して「か」や「ka」をincludes()で比較しても、そもそも文字として一致しないので、当然ヒットしません。
つまり検索アルゴリズムの不備ではなく、検索対象にひらがな・ローマ字の表現が存在しないというデータ側の不足が原因だったわけです。
クライアント側での形態素解析は採用しなかった
最初に思いついたのは、kuromoji.jsやkuroshiroのような形態素解析ライブラリをブラウザ側で読み込んで、入力時にかな推定する方法でした。
ただ検討してみると、この構成には合わないと判断しました。
- 辞書データが重い
kuromoji.js系の辞書は数MB〜数十MBあり、静的サイトに乗せるには重すぎる
- 対象規模に対してオーバースペック
- 対象は19件程度の静的しおり集で、地名(固有名詞)の読みも数が少ない
- 固有名詞の読み推定は精度が不安
- 地名の読みをライブラリの自動推定に任せると、誤読のリスクがある
自分の用途では、ページ表示のたびに辞書を読み込むコストに見合うメリットがないんですよね。
採用した方式: ビルド時に読みデータをJSONへ静的展開する
そこで採用したのが、ビルド時に読み仮名データをJSONへ静的展開する方式です。
クライアント側でのリアルタイム形態素解析・かな推定は一切行いません。
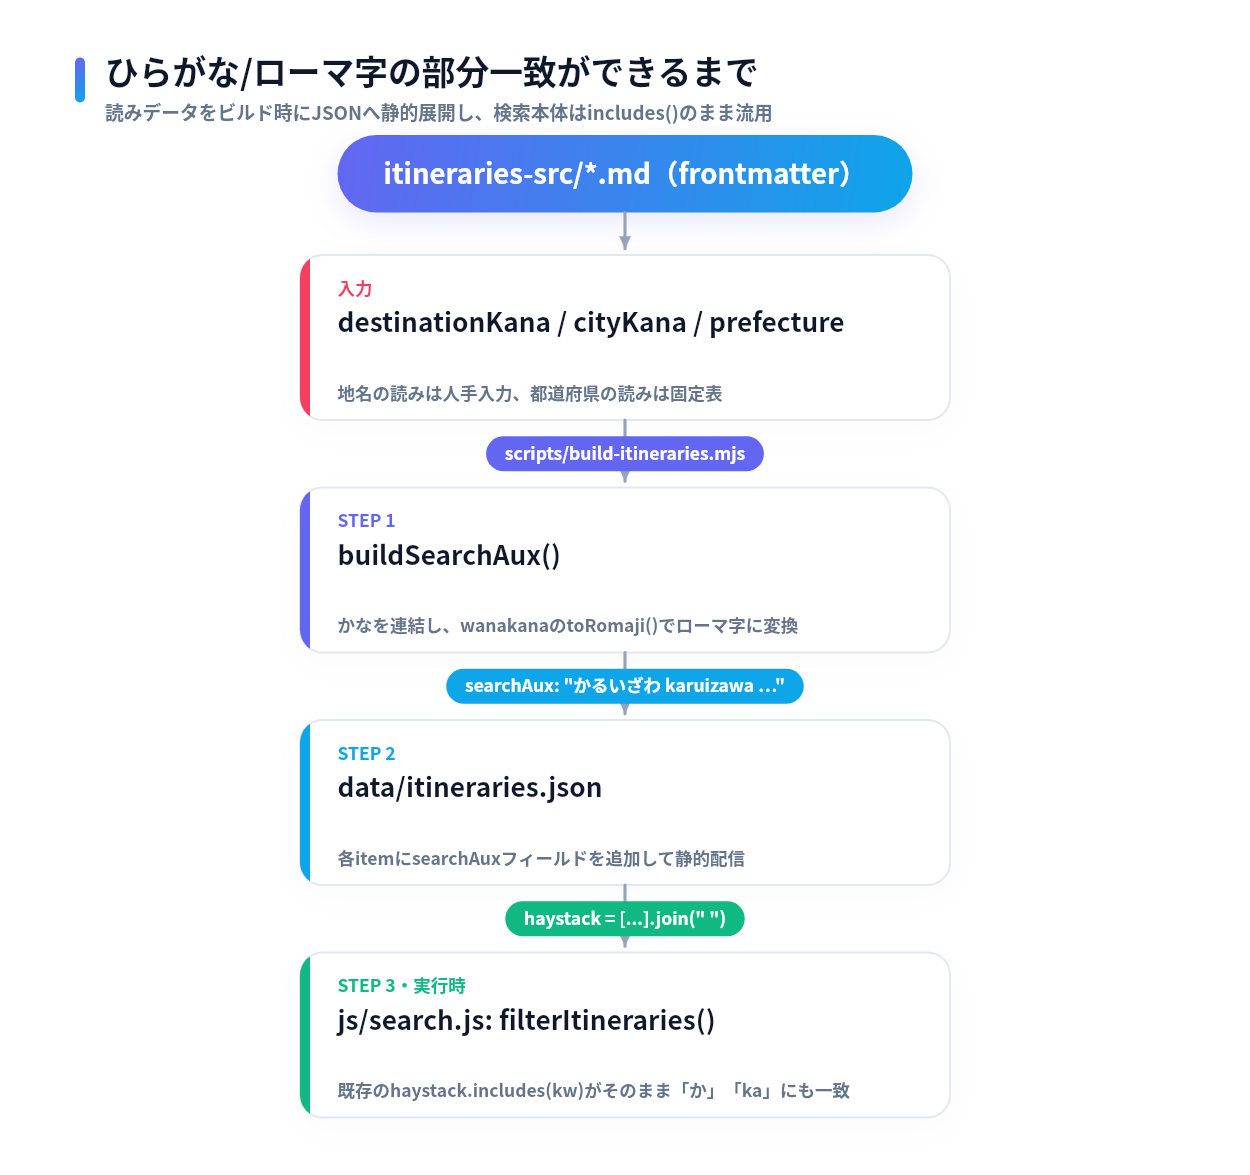
全体のデータフローはこんな感じになります。
使用ライブラリ: wanakana
ひらがな→ローマ字の変換にはwanakananpmjs.comという軽量ライブラリを使いました。devDependenciesに追加し、ビルドスクリプトの中だけで使う構成です。
wanakanaの基本的な使い方
1 | import { toRomaji } from "wanakana"; |
ビルド時のみ変換ライブラリを使うので、ブラウザに配信するJS/JSONの容量にはまったく影響しません。
ちなみにwanakanaはかな→ローマ字の一方向変換にのみ使っていて、漢字→かなの変換(読み推定)はやっていません。
読み推定はライブラリでも信頼度が低いため、後述の通り人手でfrontmatterに持たせる方式にしています。
ビルドスクリプト側の実装
scripts/build-itineraries.mjsに、読みデータを1つの文字列にまとめるbuildSearchAux()という関数を追加しました。
scripts/build-itineraries.mjs
1 | function buildSearchAux(fm) { |
この関数が返す文字列が、data/itineraries.jsonの各itemにsearchAuxフィールドとして追加されます。
data/itineraries.json(生成結果の一部)
1 | { |
都道府県名の読みは固定表で持たせる
都道府県名は47件で閉じた集合なので、PREFECTURE_KANAという固定表をビルドスクリプト内に直接埋め込みました。
PREFECTURE_KANAの一部イメージ
1 | const PREFECTURE_KANA = { |
こうしておくと、しおりのmdファイル側で都道府県の読みをいちいち書く必要がなくなります。
地名の読みは人手でfrontmatterに持たせる
一方、destination(旅行先)やcity(市区町村)は固有名詞なので、自動推定に頼らずdestinationKana/cityKanaとして各しおりのfrontmatterに人手で入力する方式にしました。
destinationKana- 旅行先の読み(例:「かるいざわ」)
cityKana- 市区町村の読み(例:「かるいざわまち」)
固有名詞の読みは、自動化よりも人手で正確に持たせた方が結果的に楽という判断です。
19件程度の規模なら、この運用コストは十分許容できますよね。
検索本体のロジックは変えていない
今回のポイントは、部分一致検索アルゴリズム自体(includes())はまったく変更していないことです。
js/search.jsのfilterItineraries()側でやったのは、haystackを組み立てる配列にsearchAuxを1つ足しただけでした。
js/search.js(変更後)
1 | const haystack = [title, destination, summary, tags, searchAux].join(" ").toLowerCase(); |
ローマ字対応特有の複雑なマッチング処理を新規に書いたわけではなく、「検索対象(haystack)にローマ字・ひらがなの表現も追加する」というデータ側の拡張だけで解決している形です。
ローマ字化はひらがな→ローマ字の一方向のみですが、ユーザーがローマ字で入力した場合の一致はtoLowerCase()で大文字小文字を無視した上での部分一致で成立しています。
たとえばkaruizawaの一部であるkaを入力すると、searchAux内のkaruizawa等に部分一致してヒットする、という仕組みですね。
E2Eテストで担保する
ひらがな/ローマ字の部分入力がちゃんと機能しているかは、tests/e2e/portal.spec.jsにPlaywrightのE2Eテストとして残しました。
新しいしおりを追加するときは
itineraries-src/FORMAT.mdの記入例を見ながら、読みフィールドの入力を忘れないようにしています。
使ってみた所感
メリット
- ブラウザ側の配信コストがゼロ
- 変換ライブラリはビルド時にしか動かないので、配信するJS/JSONの容量が増えない
- 19件程度の規模にちょうど合う
- 固有名詞の読みを人手で正確に管理できる
- 既存の検索ロジックを壊さない
includes()のロジックはそのまま、データを足すだけで対応できた
デメリット
- 新規しおり追加時に読みの入力が必須になる
destinationKana/cityKanaを書き忘れると、その地名だけ検索から漏れる
- 件数が大幅に増えると人手管理が厳しくなる
- 数百件規模になったら、別のアプローチを検討し直す必要がありそう
締め
部分一致自体は最初から実装できていたのに、原因が検索対象データの不足だったというのは、ちょっと想定外でした。
似たような「検索してもヒットしない」系の不具合は、アルゴリズムより先にデータ側を疑った方が早いこともあるんだなと実感しましたね。
以上となります。
固有名詞の読みデータは、結局のところ人力が一番正確という話でした(^^
それではお疲れさまでした。