RAG(検索拡張生成)とは?仕組みと企業・個人でのメリットをわかりやすく解説
概要
今回はRAG(検索拡張生成)について紹介していきます。
最近、仕事でRAGについて調べてレポートにまとめる機会があったので、その内容を整理しました。
AIや機械学習の専門知識がなくても理解できるように、仕組みからメリット、個人での試し方まで書いています。
それではやっていきましょう!
目次
RAG(検索拡張生成)とは何か
RAG(Retrieval-Augmented Generation/検索拡張生成)とは、AI(大規模言語モデル、LLM)が回答を作る前に、外部の資料やデータベースから関連する情報を検索し、その内容を参考にしながら回答を生成する仕組みのことです。
イメージとしては、何も見ずに記憶だけで答える人(通常のAI)と、教科書や資料を開いて調べながら答える人(RAGを使ったAI)の違いに近いです。
試験で言えば「持ち込み可の試験」のようなものですね。
AWSの公式ガイドでも、RAGは大規模言語モデルに社内文書などの外部データを組み合わせることで、特定の用途に対してより正確で有用な出力を生成させる手法だと説明されています。
RAGの仕組みの説明(AWS公式)
https://docs.aws.amazon.com/prescriptive-guidance/latest/retrieval-augmented-generation-options/what-is-rag.htmldocs.aws.amazon.com
仕組みは4ステップ
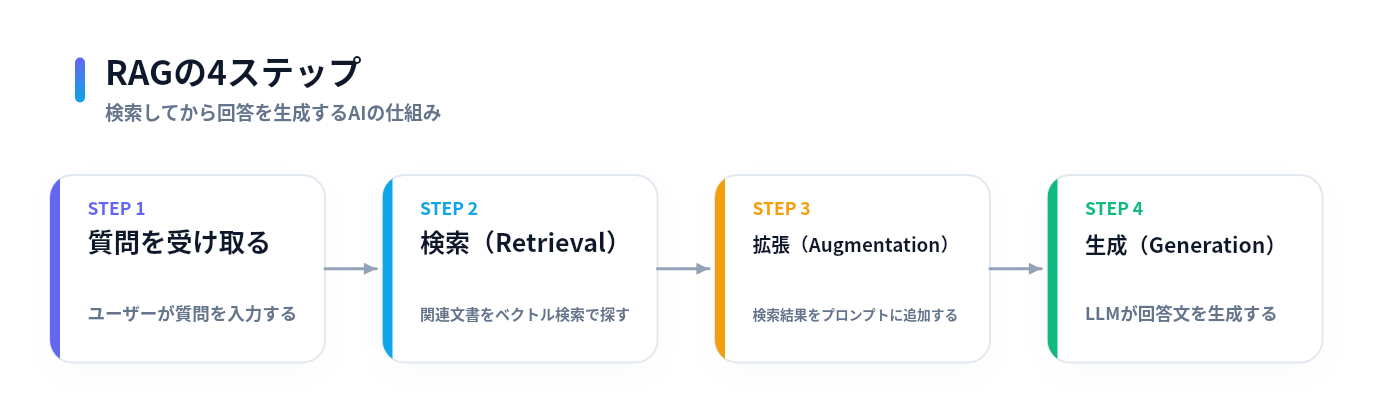
RAGの仕組みは、大きく4つのステップに分かれます。
- ①質問を受け取る
- ユーザーが質問を入力する
- ②検索(Retrieval)
- 質問に関連する文書を、社内文書や外部データベースからベクトル検索などで探す
- ③拡張(Augmentation)
- 検索で見つけた文書を、質問文と一緒にAIへのプロンプトに組み込む
- ④生成(Generation)
- AI(LLM)が、検索結果を参考にしながら回答文を作成する
図にすると、こんな流れになります。
RAGでどんなことができるのか(企業での活用)
企業がRAGを導入することで得られる代表的なメリットは、次の4つです。
①社内の情報を探す手間がなくなる
社内規定・マニュアル・過去の議事録など、大量の文書の中から必要な情報を人が手作業で探す代わりに、AIが該当箇所を自動で見つけて回答してくれます。
例えば「交通費精算の規定は?」「有給休暇の申請フローは?」といった質問に、社内規定PDFを参照して即座に回答してくれるので、総務・情報システム部門への問い合わせ対応の工数を減らせます。
②AIを再学習させなくても最新情報に対応できる
通常、AIに新しい情報を覚えさせるには「再学習(ファインチューニング)」という手間とコストのかかる作業が必要です。
RAGを使えば、参照させる文書を追加・更新するだけで、AI自体は再学習せずに最新情報を反映できます。
先週の会議資料や新しい製品仕様書をアップロードするだけで、AIがその内容を踏まえて回答できるようになるので、AIの維持・更新にかかる時間とコストを抑えられます。
③回答の根拠を示せるので正しさを確認しやすい
RAGは「どの文書を参照して回答したか」を提示できます。
そのため、AIが答えた内容が本当に正しいかどうかを、参照元の文書に立ち返って確認できます。
通常のAIは、もっともらしいが誤った内容を自信満々に答えてしまう「ハルシネーション(もっともらしい嘘)」を起こしやすいですが、RAGは実在する社内文書を根拠にするため、この誤りを減らせます。
④ノウハウの属人化を防げる
ベテラン社員しか知らない過去の対応事例や技術文書をRAGに読み込ませておけば、経験の浅い社員でも「このエラーが出たときの対処法は?」といった質問に対して、過去の事例を踏まえた回答を得られます。
技術伝承や引き継ぎの効率化につながりますね。
この4つを表にすると、次のようになります。
| 効率化されるもの | 具体的な内容 |
|---|---|
| 情報収集の手間 | 大量の文書から手動で探す作業をAIが代行 |
| AIの更新コスト | 再学習せずに最新情報・専門情報を反映できる |
| 回答の正確性チェック | 出典付きで回答するため、事実確認の手間が減る |
| ノウハウの属人化解消 | ベテランの知見や過去資料をAIが検索・参照できる状態にできる |
個人でRAGを作るメリット
企業だけでなく、個人がRAGを構築することにも実用的なメリットがあります。
- 自分専用の文脈をAIに持たせられる
- 汎用AIは自分が個別に対応しているタスクや過去の経緯を知らないが、自分のメモや過去のドキュメントをRAG化すれば、業務背景を理解した回答をもらえる
- あいまいな質問にも対応しやすくなる
- ベクトルDB(例:Chroma)による意味検索を使うと、キーワードが完全一致しない質問でも近い文脈の情報を引き出せる
- 開発ツールに組み込んで作業効率化できる
- VS CodeのCopilot ChatなどにローカルRAGを接続し、Confluenceやローカルファイルを検索対象にすれば、過去の検討結果を引用しながら回答させられる
- プライバシー・機密情報を保護できる
- ローカルLLM+RAGの構成にすると、データを外部サーバーに送信せずに処理できるため、機密性の高い情報でも扱いやすい
- 学習・実験がしやすい
- クラウドサービスの制約を受けず、自分のペースでRAGの仕組みそのものを学べる
一方で、個人利用における現実的な注意点もあります。
ローカル環境でRAGを動かすと、クラウドAIに比べて推論速度が遅くなりやすく、ナレッジベースが増えるほど遅くなる傾向があります。
快適に使うにはある程度のPCスペック(特にGPU)が必要になりますし、機密情報を扱う必要性が薄いなら、無理にローカルで構築しなくても、速度や手軽さの面ではChatGPTやClaudeなどのクラウドAIの方が効率的な場合も多いです。
個人で試す場合の最小構成
代表的な実装方法は、Pythonのフレームワーク「LangChain」を使う方法です。
以下は個人ブログや技術記事で紹介されている典型的な最小構成の流れです。
ここで紹介する手順は技術検証記事からの引用が中心で、公式一次情報がまとまった形では見つからなかったため、参考情報として記載しています。
- ①環境構築
- Pythonをインストールし、必要なライブラリを導入する
- ②資料を用意する
- 参照させたいテキストファイル・PDF・Markdownなどを用意する
- ③チャンク分割
- 長い文書を検索しやすい小さな断片(チャンク)に分割する。質問に近い文脈だけを取り出せるよう、適度なサイズに切り分けるのが一般的
- ④埋め込みとベクトルDBへの格納
- 分割したテキストを数値ベクトルに変換し、ベクトルデータベース(Chroma、FAISSなど)に保存する。これにより意味が近い文章を検索できるようになる
- ⑤検索+生成のチェーンを組む
- ユーザーの質問が来たら、ベクトルDBから関連チャンクを検索し、質問文と一緒にプロンプトに組み込み、LLM(OpenAIのAPIやローカルLLMなど)に渡して回答を生成する
必要なライブラリのインストール
1 | pip install langchain langchain-community langchain-openai langchain-chroma faiss-cpu |
コードを書きたくない場合は、Amazon Bedrock Knowledge Basesのようなマネージドサービスを使う手もあります。
文書をアップロードするだけでRAGの検索基盤を用意できるので、実装の手間を省きたいときに向いていますね。
締め
自分が作ったものってなんだっけ?っ毎回資料を漁る手間がだいぶ減りました!
自分特化のAIが欲しい方はやった方が良いです!
楽しいですよ(^^
個人の学習目的であれば、まずはLangChain公式のRAGチュートリアルで、小規模なテキストファイル数個から始めるのがお勧めです(^^
LangChain公式のRAGチュートリアル
https://docs.langchain.com/oss/python/langchain/ragdocs.langchain.com
以上となります。
作りはシンプル、作り込むと難しい。職人芸ですね!
それではお疲れさまでした。