ソフトウェアエンジニア・SEが知っておきたいAI用語75選|AGI・LLM・ハーネスを一覧で整理
概要
今回はソフトウェアエンジニア・SEが知っておきたいAI用語75選について、AGI・LLM・ハーネスなど実務でよく出る言葉をカテゴリ別に1行の定義で解説していきます。
AI開発ツールが一気に広まって、会議やチャットで「ハーネス」「コンテキストエンジニアリング」「MCP」などの言葉が当たり前のように飛び交うようになりました。
なんとなく雰囲気で頷いているけれど、正確な意味は怪しい、という方も多いと思います(- -;
そこで、実務でよく出る用語だけを厳選して、カテゴリごとに「一言で言うと」の1行定義でまとめました。
気になる用語だけ拾い読みしても大丈夫です。
時間がない方は、冒頭の「用語の進化の流れ」と、日常的に目にすることが多いLLMの基本(第2章)・エージェント(第6章)から読むのがお勧めです。
AI用語はまだ新しく、人によって使い方が違うことがあります。
ここでは現時点で一般的な意味で説明しているので、今後ニュアンスが変わる可能性がある点だけご留意を!
それではやっていきましょう!
目次
用語の進化の流れ(先に全体像)
個別の用語に入る前に、最近よく聞く3つの「〜エンジニアリング」の関係を押さえておくと、あとの用語がかなり頭に入りやすくなります。
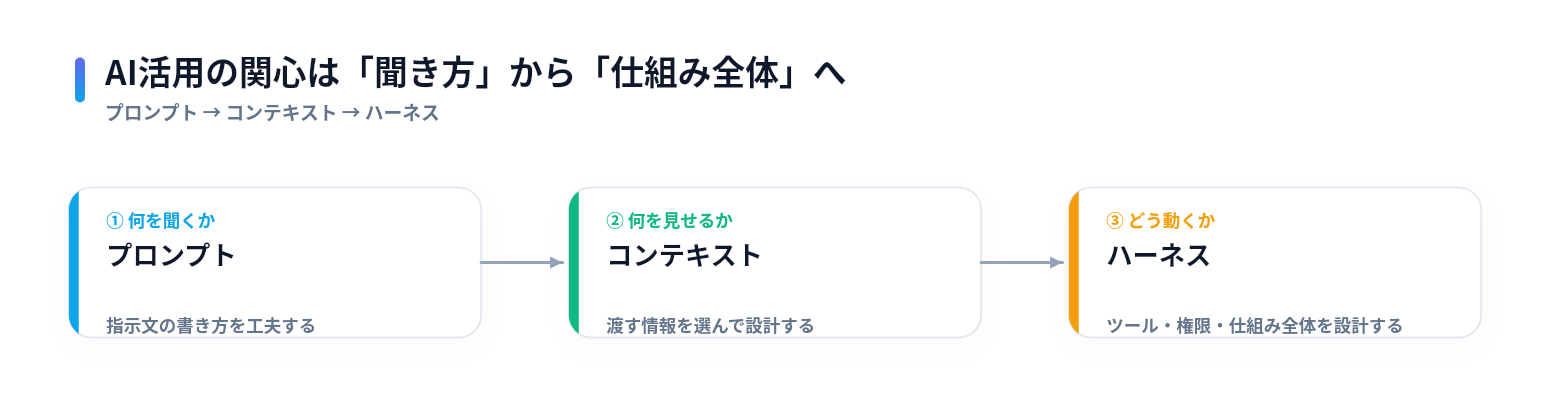
- プロンプトエンジニアリング:AIに「何を聞くか」を工夫する
- コンテキストエンジニアリング:AIに「何を見せるか」を設計する
- ハーネスエンジニアリング:AIが「どう動くか」の仕組み全体を設計する
質問の仕方 → 渡す情報 → 動く環境全体、と関心の範囲が広がってきたと覚えておけばOKです。
1. 基礎
まずは「AIって結局なに?」という土台の用語です。
AI・機械学習・ディープラーニングは「大きな枠 → その中の方法 → さらにその中の方法」という包含関係なので、ここだけは覚えておきましょう。
| 用語 | 一言で |
|---|---|
| AI / 機械学習 / ディープラーニング | AI=人の知的作業をまねる技術全般。機械学習=AIのうち、データから学ぶ方法。ディープラーニング=機械学習のうち、多層のニューラルネットワークで学ぶ方法 |
| ニューラルネットワーク | 脳の神経細胞をまねた計算のしくみ |
| 生成AI(Generative AI) | 文章・画像・コードを新しく作るAI |
| LLM(大規模言語モデル) | 大量の文章を学んで「次の言葉」を予測するAI |
| Transformer | 現在のLLMの土台になっているしくみ。文中のどの単語が重要かを判断する「Attention」という仕組みを持つ |
| パラメータ | モデルが学習で身につけた数値。7B=70億個で、多いほど高性能になりやすいが動かすのが重くなる |
| 学習(Training)と推論(Inference) | 勉強する段階と、答えを出す段階 |
| GPU | AIの計算が得意な処理装置。単純な計算を大量に並列で処理できる |
| 基盤モデル(Foundation Model) | いろいろな用途に転用できる大きな土台モデル |
| マルチモーダル | 文章・画像・音声など複数の種類を扱える |
ChatGPTやClaudeのような会話AIは、このうち「生成AI」かつ「LLM」にあたります。
LLMはあくまで「次に来そうな言葉を当てる」仕組みなので、後半で出てくるハルシネーションの話にもつながってきます。
2. LLMの基本
LLMを使うと必ず出てくる、仕組みと調整まわりの用語です。
| 用語 | 一言で |
|---|---|
| トークン(Token) | LLMが扱う文字の最小単位。日本語は1文字が1〜数トークンで、料金と長さの単位になる(文字数に近いが同じではない) |
| コンテキストウィンドウ | 一度に読める・覚えていられる量の上限。広いほど長い資料や会話を扱える |
| 事前学習(Pretraining) | 大量のデータで最初にする基礎学習 |
| ファインチューニング | 特定の用途向けに追加学習する |
| RLHF | 人間の好みで評価してAIを調整する |
| LoRA | 全部でなく一部だけ調整する軽い追加学習 |
| 量子化(Quantization) | 数値の精度を落として軽くする |
| 蒸留(Distillation) | 大きなモデルの知識を小さなモデルに教え込む |
| 温度(Temperature) | 回答のランダムさの度合い。低いと安定し、高いと多様だがブレやすい |
| ハルシネーション | もっともらしい間違いを自信満々に言う |
| ベンチマーク | モデルの性能を測る共通テスト |
| 推論モデル(Reasoning Model) | 答える前に時間をかけて考えるモデル |
トークンとコンテキストウィンドウは、料金と「どこまで読めるか」に直結するので、実務では一番よく気にする用語です。
ハルシネーションは「AIは平気で間違える」前提で、出力を必ず確認する癖をつけておくのが現実的ですね。
3. AGI・概念
ニュースやSNSでよく見る、少し大きな話の用語です。
| 用語 | 一言で |
|---|---|
| AGI(汎用人工知能) | 人間と同じくらい幅広い仕事をこなせる想像上のAI |
| ASI(超知能) | 人間を大きく超えるAI |
| アライメント | AIの目的・行動を人間の意図に合わせること |
| ペルソナ(Persona) | ①AIに与える役割・人格 ②想定する利用者像(マーケ・設計用語)。文脈で意味が違う |
| ステートレス | 前回のやりとりを覚えていない性質。会話をつなぐには毎回これまでの履歴を渡し直す必要がある |
AGIは現時点ではあくまで「目標としてのAI」で、実在する製品を指す言葉ではありません。
ペルソナだけは文脈で意味が変わるので、会議で出たらどちらの意味か確認した方が安全です。
ステートレスはあとのコンテキスト系の用語にも効いてきます。
会話を覚えているように見えるのは、実は毎回これまでの履歴をまるごと渡し直しているからなんです。
4. プロンプト・思考
AIへの指示の出し方と、考えさせ方の用語です。
| 用語 | 一言で |
|---|---|
| プロンプト | AIへの指示文 |
| システムプロンプト | AIの役割・ルールを最初に決める指示 |
| Zero-shot / Few-shot | 例なしで頼む/数個の例を見せて頼む |
| In-context learning | 例を見せるだけで、その場でやり方を覚える |
| Chain of Thought(思考の連鎖) | 途中の考え方を順に書き出させる |
| Extended Thinking | モデルがじっくり考える時間を使う機能 |
| ReAct | 考える→道具を使う→結果を見て考える、を繰り返す型 |
| 構造化出力(JSON等) | 決まった形式で返させる。プログラムが結果を処理しやすくなる |
| Function calling | AIが「この関数をこの引数で呼びたい」と指定し、プログラム側が実行する仕組み |
| ジェイルブレイク | 制限をすり抜ける入力で禁止事項をやらせる |
Chain of ThoughtとExtended Thinkingは、どちらも「考えさせてから答えさせる」系の用語です。
ひとまず「思考系」とまとめて覚えておくと混乱しません。
また、Function callingや構造化出力は、AIの返答をプログラムが扱える形にするための実装寄りの用語です。
5. 〜エンジニアリング/開発スタイル
冒頭の進化の流れに出てきた用語を含む、開発の進め方の名前です。
| 用語 | 一言で |
|---|---|
| プロンプトエンジニアリング | 指示文を工夫して結果を良くする |
| コンテキストエンジニアリング | 必要な情報だけをちょうどよく渡す設計 |
| ハーネスエンジニアリング | AIを動かす周辺の仕組み(ツール・権限・記憶・検証)を設計する |
| エージェンティックエンジニアリング | AIエージェントに任せつつ、品質を保つ工学的な進め方 |
| AI駆動開発 | AIを主役級に使ってソフトを作る |
| バイブコーディング | コードを細かく読まず、AIに任せて雰囲気で進める |
| スペック駆動開発 | 先に詳しい仕様書を書き、AIに実装させる |
| MLOps / LLMOps | AIを運用・監視・改善し続ける仕組み |
| Human-in-the-loop | 重要な判断に人が入る |
バイブコーディングは試作や使い捨てには便利ですが、本番に出すコードを読まずに通すのはさすがに怖いです。
その反対側にあるのが、仕様を先に固めるスペック駆動開発やHuman-in-the-loopで、速さと安全のバランスをどこで取るかが各用語の違いになっています。
6. エージェント
今いちばん新しい用語が増えているのがこのエリアです。
Claude CodeなどのAI開発ツールを使っていると、日常的に目にします。
| 用語 | 一言で |
|---|---|
| エージェント | 目標に向けて自分で考え、道具を使って動くAI |
| エージェントループ | 「考える→実行→結果確認」の繰り返し |
| ツール呼び出し | AIがファイル操作・検索・実行などを使う |
| MCP(Model Context Protocol) | AIと外部ツールをつなぐ共通ルール |
| スキル(Skills) | 特定作業の手順書。必要なときだけ読み込む |
| サブエージェント | 親AIが呼び出す、専用の子AI |
| フック(Hooks) | 特定のタイミングで必ず動く自動処理 |
| プランモード | 変更せず、計画だけ立てるモード |
| ハーネス | AI本体ではなく、エージェントを動かす周りのソフト全体(指示・ツール・権限・出力管理) |
| マルチエージェント / オーケストレーター | 複数のAIで分担/指揮役のAI |
| CLAUDE.md / AGENTS.md | AIに毎回読ませるプロジェクトの説明書 |
| サンドボックス | 壊れても影響しない隔離環境 |
| ワークツリー | 同じGitリポジトリを、別ブランチ用に別フォルダで同時に開く機能。AIの並行作業で衝突を避けられる |
| コンパクション / コンテキストロット | 長い会話を要約して短くする/コンテキストに情報が増えすぎて回答精度が落ちる現象 |
タイトルにもあるハーネスは「AI本体ではなく、AIを動かす周りの仕組み全部」のことです(先ほどの「ハーネスエンジニアリング」は、これを設計する取り組みを指します)。
同じAIモデルでも、ハーネス(ツール・権限・指示の出し方)が違えば使い勝手も成果も大きく変わります。
スキル・フック・サブエージェント・MCPあたりは、すべてハーネスを構成する部品だと考えるとスッキリします。
CLAUDE.mdに毎回守らせたいルールを書き、フックで必ず動かしたい処理を固定し、サンドボックスで安全に試す、という使い分けですね。
7. RAG・検索
AIに「自分の資料」を踏まえて答えてもらうときの用語です。
| 用語 | 一言で |
|---|---|
| RAG(検索拡張生成) | 外部の資料を検索して、その内容を踏まえて答える |
| 埋め込み(Embedding) | 文章の意味を数値の並び(ベクトル)にしたもの。意味が近い文章ほど数値も近くなる |
| ベクトルDB | 埋め込みを保存して、似たものを探せるDB |
| セマンティック検索 | 単語の一致ではなく意味で探す |
| チャンク分割 | 長い文書を適切な大きさに切る |
| グラウンディング | 回答を確かな資料・事実に結びつける |
RAGは「AIが知らない社内資料や最新情報を、検索して渡す」ための型で、ハルシネーション対策にもよく使われます。
埋め込み、ベクトルDB、セマンティック検索、チャンク分割はそのRAGを支える部品、と整理すると関係がつかみやすいです。
8. 品質・セキュリティ
AIを実務で使うなら避けて通れない、品質管理と安全面の用語です。
| 用語 | 一言で |
|---|---|
| Eval(評価) | AIの出力を繰り返し測るテスト |
| LLM-as-a-judge | AIに別のAIの回答を採点させる |
| ガードレール | 危険な出力や入力を防ぐ仕組み |
| プロンプトインジェクション | 悪意ある文章でAIの指示を乗っ取る攻撃 |
| ツールポイズニング | ツールの説明文に罠を仕込む攻撃 |
| オブザーバビリティ(トレース) | AIが何をしたか追えるようにする |
| レート制限 | 短時間に使える回数の上限 |
| コスト管理(トークン課金) | 使ったトークン量で料金が決まる |
| PII・情報漏えい | 個人情報や機密がAIに渡る/出てくる危険 |
エージェントに外部のWebページやファイルを読ませる場合、そこに書かれた指示文に引っ張られるプロンプトインジェクションに注意が必要です。
ツールをつなぐほど攻撃される入口が増えるので、権限は最小限にして、重要な操作は人が確認する形にしておくのが安全です。
「ガードレール」「権限の絞り込み」「Human-in-the-loop」はセットで使うことが多く、第5章・第6章の用語ともつながっています。
締め
いかがでしたか?
全部覚えようとすると大変ですが、ひとまず「プロンプト → コンテキスト → ハーネス」の流れと、トークン・コンテキストウィンドウ・ハルシネーションの3つだけ押さえておけば、会議の会話にはだいぶ付いていけるはずです。
この分野は用語の入れ替わりが早くて、半年後にはまた知らない言葉が増えていそうなのが正直ちょっと怖いところですね。
新しい用語を見かけたら、この記事を随時見直して確認していければと思っています。
正直自分もまだ覚えられていませんが、聞いたことあるな?くらいにはしておきたいですね(^^
以上となります。
新しい技術はすぐ新しい単語を作りたがるので、やめてほしい…
それではお疲れさまでした。