ObsidianのナレッジベースをローカルRAGでチャット化した話|Ollama+Chromaで完全ローカル構築
概要
今回はClaude Codeの開発ナレッジを貯めているObsidian vaultを、ローカルRAGでチャット検索できるようにした話について紹介していきます。
普段Claude Codeで開発していると、セッションのやり取りや直したバグ、気づいたパターンがどこかに流れていってしまいますよね。
これを毎週自動でObsidian vaultに蓄積する仕組みは既に動かしていたのですが、貯まる一方で「振り返る」手段がありませんでした。
せっかく構造化して溜めているので、チャットで検索できるようにしようというのが今回の動機です。
それではやっていきましょう!
目次
なぜ作ったか
自分は開発ナレッジ同期という仕組みを既に運用していて、Claude Codeのフックを使ってセッション内容を自動でObsidian vaultに蓄積しています。
vault側は次の5つのフォルダに分かれています。
- 10_プロジェクト
- プロジェクトごとの要約
- 20_パターン
- 横断的に使える実装パターン
- 30_知見
- 過去の躓きと対策
- 40_QA
- セッション中のQ&Aログ
- 50_傾向
- 自分の編集傾向の統計
ただ、たまる一方で「あのプロジェクトで何をやったっけ」「最近自分は何を気にしがちなんだっけ」を知りたくなったとき、Obsidianを開いて手で検索するしかありませんでした。
このai時代に流石に不便すぎると思ったのが、やった理由です。
要件
今回作るものには、次の3つを求めました。
- チャットで聞ける
- 「何をやったか」「自分の傾向」を都度質問できる
- 完全ローカルで完結
- API課金なし、vaultの中身を外部に送らない
- 他プロジェクトにもすぐ複製できる
- 「これと同じ機能を別プロジェクトにも」と頼んだときに使い回せる作り
全体アーキテクチャ
全体の流れは次のようになっています。
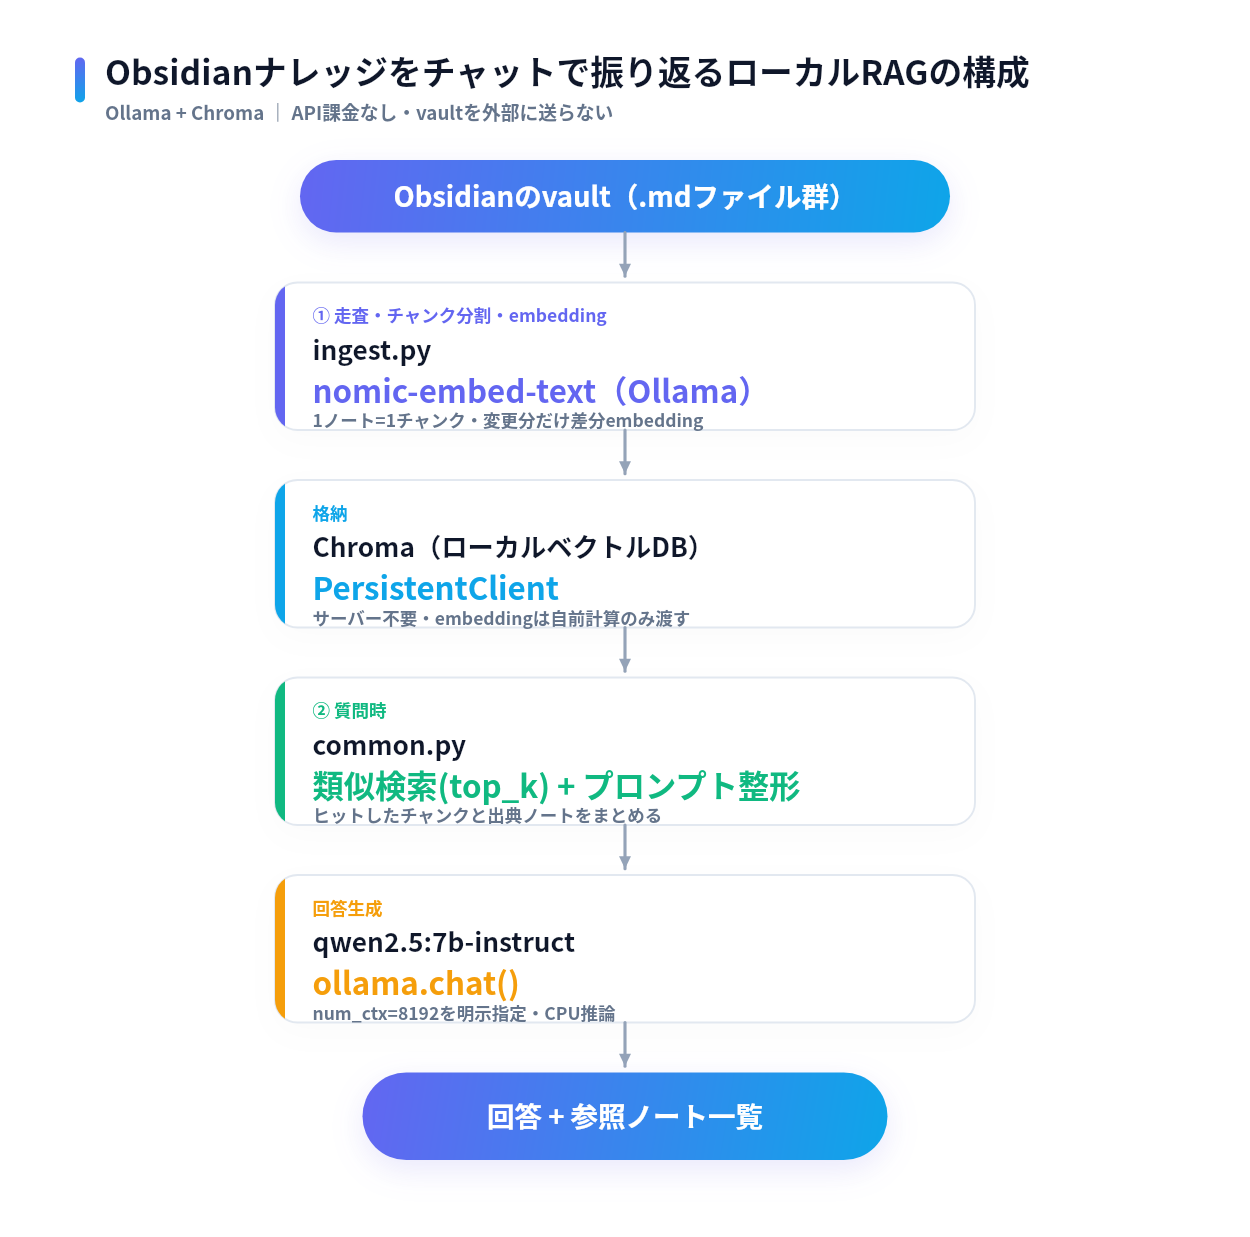
構成要素はどれも「PC内で完結する」もので統一しています。
- Ollama
- Meta/Alibaba/Google等が公開しているオープンウェイトLLMを自分のPCだけで動かすOSSランタイム。埋め込み(
nomic-embed-text)とチャット(qwen2.5:7b-instruct)の両方をこれ1本でまかなう
- Meta/Alibaba/Google等が公開しているオープンウェイトLLMを自分のPCだけで動かすOSSランタイム。埋め込み(
- Chroma
- 組み込み型のベクトルDB。サーバー不要でPythonから
PersistentClient一発で使える。embeddingは自前で計算してそのまま渡すので、Chroma内蔵のオンライン埋め込みモデル(自動ダウンロードしようとするもの)は一切使わない
- 組み込み型のベクトルDB。サーバー不要でPythonから
なぜこの設計にしたか
Claude Codeのトークンを増やさないため、検索・回答生成はOllama上のローカルLLM(qwen2.5:7b-instruct)で完結させています。
vaultの中身をClaudeに直接読ませるのではなく、ローカルでRAG検索・回答生成まで済ませてから結果だけを返す構成にしたのはこの理由からです。
自分の低スペックPCでもなんとか動かすため、以下も選びました。
- Ollamaのインストール方法
- sudoも常駐サービス化もしないtarball手動展開にした
- チャンク分割は「1ノート=1チャンク」
- ノート自体が十分小さいので、これで十分
- 差分embedding
- 変更・新規分だけ再embeddingする。vaultが増えても負荷は増えない
自動更新の仕組み
vaultは既存の仕組みでセッション終了時・週次バッチで自動更新されているので、RAG側のインデックスもそこにそのまま組み込みました。
週次バッチの方は時間制約がないので、50_傾向/の全面再生成などを行う既存処理の後に、今度は同期的にrag/ingest.pyを実行しています。
どこからでも呼べるようにする
このRAGを開発ナレッジ同期プロジェクトの中に閉じず、どのプロジェクトのClaude Codeセッションからでも呼べるようにするため、グローバルSkillとして登録しました。
配置場所
1 | ~/.claude/skills/dev-knowledge-rag/SKILL.md |
中身はpython rag/query.py "<質問>"を呼ぶだけの薄いラッパーです。
Claude Codeのグローバル設定に置くことで、新規プロジェクトでも自動的に「過去に何をやったか」を聞かれたときにこのSkillが発火するようになります。
ファイル構成
ディレクトリ構成
1 | ~/Programming/開発ナレッジ同期/ |
使い方
再indexing
1 | # 初回 or vault更新後の再indexing(差分のみ再embeddingされる) |
チャット
1 | # 対話チャット |
ちなみにollama serveが起動していなければ、スクリプト側が自動でバックグラウンド起動して待ってから処理してくれます。
ハマった点
構築中にいくつか足を止められた箇所があったので、記録として残しておきます。
- GitHubのリリースアセットへのリダイレクトが固まる
github.com自体は許可されていても、リリースファイルの実体はrelease-assets.githubusercontent.comにリダイレクトされる。許可ホスト外だとプロキシがエラーを返さず無言でハングするため、遅い/固まっているように見えたら「許可されていないホストへのリダイレクト」を疑うとよい
- pip installでも同様の問題
pypi.org宛のリクエストが同じ理由でハングする
ollama pullが大きいレイヤーの再開時にEOFで失敗し続けた- 一度失敗した
-partial系の一時ファイルが壊れた状態で残っていると、再開ロジックがそれを踏んでしまい、何度リトライしてもError: EOFになる。~/.ollama/models/blobs/配下の*-partial*を削除してから再度ollama pullすればクリーンに再取得できる
- 一度失敗した
- 回答生成中に500エラーで落ちる
- 検索でヒットした上位8件のチャンクを詰め込むと、プロンプトが約3600トークンに達し、Ollamaのデフォルトのコンテキスト長(
num_ctx=4096)にほぼ達してしまう。生成中にオーバーフローして500エラーになっていた。ollama.chat()呼び出し時にoptions={"num_ctx": 8192}を明示的に渡すことで解決した
- 検索でヒットした上位8件のチャンクを詰め込むと、プロンプトが約3600トークンに達し、Ollamaのデフォルトのコンテキスト長(
実際の使用感
CPU推論なので、モデルロードに約30秒、プロンプト処理は実測13トークン/秒程度です。
3600トークンのプロンプトを投げると、生成込みで1問あたり数分かかります(- -
ChatGPT感覚のレスポンスを期待すると2かなり遅いですが、「バックグラウンドで聞いておいて後で結果を見る」使い方であれば十分実用的です。
速度を優先するならconfig.yamlのchat_modelを軽量モデル(qwen2.5:3b-instructなど)に変えればマシになります!
トークン/コストの整理
完全ローカルなのでAPI課金は一切発生しません。
コストがかかるのは初回のindexing(vault全体のembedding、一度きり)と、質問のたびのCPU計算時間だけです。
vaultのノート数がどれだけ増えても、質問1回あたりに使うコンテキスト量(top_k固定)は変わりません!
締め
こんな感じでまとめてみました!
今週何やったかや、このプロジェクトのこの機能ってなんだっけ?
みたいな質問も投げられるので、速度問題さえ解決すれば最高の仕組みですね!
スペックは…頑張りましょ
以上となります。
自分専用のAIはかなり暑いですよね!
それではお疲れさまでした。